Hugging Face Blog
Jun 29, 2023
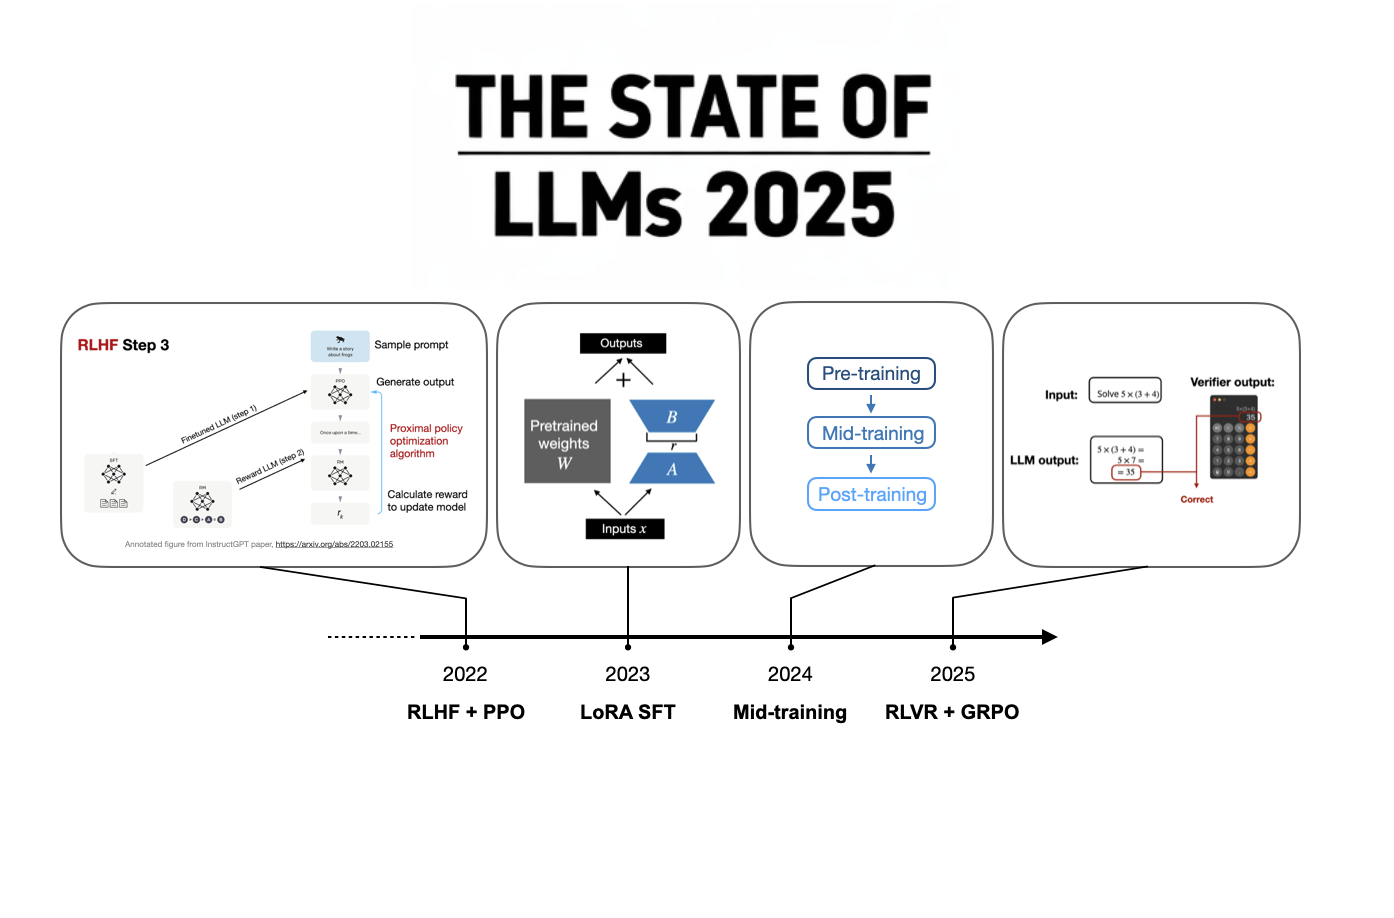
A 2025 review of large language models, from DeepSeek R1 and RLVR to inference-time scaling, benchmarks, architectures, and predictions for 2026.
arXiv:2608. 09703v1 Announce Type: new Abstract: Training a language model suite classically requires training each model separately and serving them independently.
Decoder-only language models entangle long-term memory and reasoning in a single parameter set, making it difficult to scale memory capacity independently. Memory Decoder introduces a parametric long-term memory module but only studies it at a relatively small scale.
arXiv:2609.12475v1 Announce Type: new Abstract: Comprehensive benchmark suites are essential for improving large language models (LLMs), but many widely used benchmarks are redundant, making evaluati...